

Wat is een robots.txt-bestand en waarom is het belangrijk?
Als je een website hebt, wil je dat Google de juiste pagina's te zien krijgt. Niet elke pagina is even interessant voor een zoekmachine. Beheerderspagina's, interne zoekresultaten, testpagina's, je wilt niet dat die zomaar geïndexeerd worden. Dat is precies waar een robots.txt-bestand voor dient.
Wat is robots.txt?
Het robots.txt-bestand is een klein tekstbestand dat je in de hoofdmap van je website plaatst. Je kunt het bereiken via jouwedomein.nl/robots.txt. Zoekmachines zoals Google lezen dit bestand automatisch als ze je site bezoeken. Op basis van de regels daarin beslissen ze welke pagina's ze mogen crawlen en welke niet.
Crawlen betekent simpelweg dat een zoekmachine je pagina bezoekt om de inhoud te lezen en te bewaren in zijn index. Pagina's die in de index staan, kunnen verschijnen in zoekresultaten. Pagina's die geblokkeerd zijn via robots.txt, worden in principe overgeslagen.
Hoe ziet een robots.txt-bestand eruit?
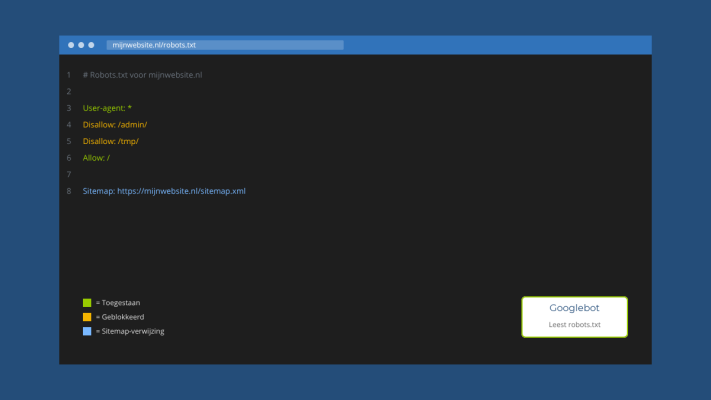
De opbouw is vrij eenvoudig. Een basale versie ziet er zo uit:
- User-agent: * betekent dat de regel voor alle zoekmachines geldt
- Disallow: /admin/ blokkeert de beheerdersomgeving
- Allow: / geeft toegang tot de rest van de website
- Sitemap: hier kun je ook de URL van je sitemap toevoegen
Je kunt meerdere regels toevoegen en zelfs aparte instructies geven aan specifieke zoekmachines. Zo kun je Google andere rechten geven dan bijvoorbeeld Bing.
Wat blokkeer je beter wel en wat niet?
Dit is waar het soms misgaat. Pagina's die je typisch wilt blokkeren zijn beheerdersomgevingen, inlogpagina's, interne zoekresultaten en tijdelijke of testpagina's. Pagina's die je juist niet wilt blokkeren zijn je homepage, blogposts, productpagina's en contactpagina's.
Een veelgemaakte fout is het per ongeluk blokkeren van CSS- of JavaScript-bestanden. Google heeft die bestaan nodig om je pagina correct te kunnen weergeven en beoordelen. Als die geblokkeerd zijn, kan dat je vindbaarheid schaden zonder dat je het doorhebt.
Robots.txt is geen beveiligingslaag
Dit punt verdient extra aandacht. Een robots.txt-bestand is een verzoek, geen verplichting. Nette zoekmachines zoals Google houden zich er netjes aan, maar kwaadwillende bots of scrapers trekken zich er niets van aan. Als je een pagina écht wilt afschermen, heb je een wachtwoord of andere beveiliging nodig.
Werkt robots.txt samen met je sitemap?
Ja, en dat is slim om te combineren. In een eerder artikel schreven we al over wat een sitemap is en hoe Google je site daardoor beter begrijpt. Je kunt de URL van je sitemap onderaan je robots.txt-bestand plaatsen. Zo vindt Google hem makkelijker en weet hij direct welke pagina's je wilt laten indexeren.
Hoe controleer je of robots.txt goed werkt?
Via Google Search Console kun je het robots.txt-bestand testen. Je ziet dan direct welke pagina's geblokkeerd of toegestaan zijn. Dit is handig als je vermoedt dat bepaalde pagina's niet geïndexeerd worden terwijl dat wel zou moeten.
Heb je hulp nodig bij het goed instellen van je robots.txt, je sitemap of andere technische zaken rondom vindbaarheid? Neem gerust contact op, ik help je er graag doorheen.
Verder lezen